Gå til indhold
Jan Engelbrecht Pederseb Logo

LLM Modeller

Hvad er LLM modeller, hvordan virker de og hvordan afvikler man dem lokalt.

LLM Modeller

Hvad er LLM modeller, hvordan virker de og hvordan afvikler man dem lokalt.

En LLM (Large Language Model eller stor sprogmodel) virker i bund og grund som en ekstremt avanceret udgave af ordforslaget på din smartphone. Den gætter hele tiden på, hvad det næste logiske ord i en sætning bør være.

LLM Modeller Illustration
Jan der arbejder med AI modeller på flere skærme

Grundlæggende funktion

Hvad er LLM modeller , hvordan virker de og hvordan afvikler man dem lokalt.

En LLM (Large Language Model eller stor sprogmodel) virker i bund og grund som en ekstremt avanceret udgave af ordforslaget på din smartphone. Den gætter hele tiden på, hvad det næste logiske ord i en sætning bør være.

Her er en simpel forklaring på, hvordan det fungerer i praksis, opdelt i tre hovedtrin:

1. Træningen: Den har læst (næsten) hele internettet

Før en sprogmodel kan svare på spørgsmål, skal den lære, hvordan mennesker skriver.

  • Data: Udviklerne fodrer modellen med enorme mængder tekst – bøger, artikler, hjemmesider og Wikipedia.
  • Mønstre: Modellen læser ikke teksten for at "forstå" den, som du og jeg gør. I stedet leder den efter statistiske mønstre. Den lægger mærke til, hvilke ord der typisk følger efter hinanden. For eksempel ved den, at hvis der står "København er Danmarks...", så er der ekstremt stor sandsynlighed for, at det næste ord er "hovedstad".

Sprogforståelse og Svaret

2. Sprogforståelsen: Ord omdannes til tal

Computere forstår ikke bogstaver, de forstår kun tal.

  • Tokens: Modellen hakker teksten op i små bidder (kaldet tokens), som kan være hele ord eller dele af ord.
  • Koordinatsystem: Hvert token får tildelt en plads i et gigantisk, digitalt koordinatsystem (en såkaldt embedding). Ord, der minder om hinanden eller ofte bruges i samme sammenhæng (f.eks. "hund" og "hvalp"), bliver placeret tæt på hinanden. På den måde får modellen en matematisk forståelse af ords betydning og forhold til hinanden.

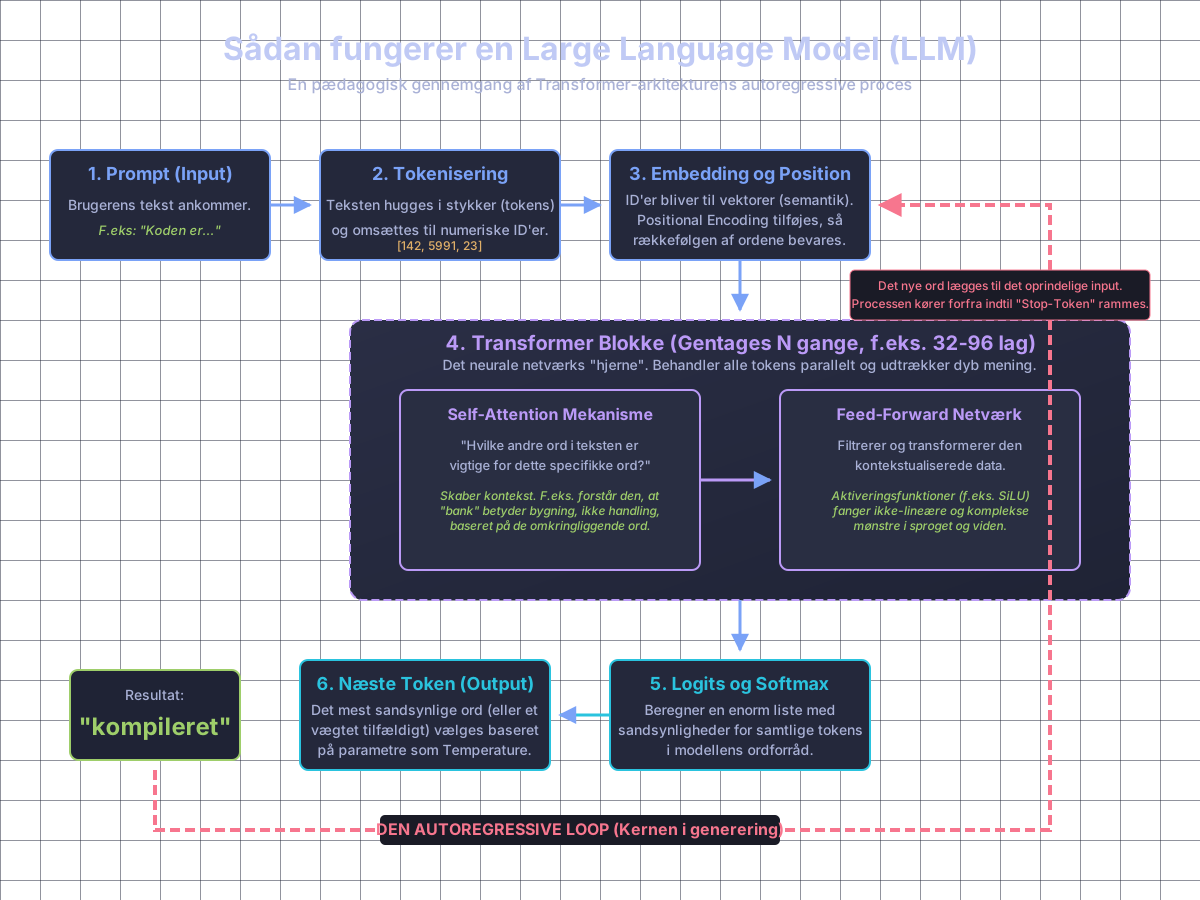
3. Svaret: Den gætter ord for ord

Når du stiller en LLM et spørgsmål, går dens "gættemaskine" i gang:

  • Den analyserer dit spørgsmål og beregner, hvilket ord der vil være det mest naturlige at starte svaret med.
  • Når den har fundet det første ord, tager den både dit spørgsmål og det første ord, den lige har skrevet, og bruger det til at gætte det næste ord.
  • Processen gentager sig lynhurtigt: Ord 1 fører til ord 2, som fører til ord 3, indtil sætningen er færdig.

Hvorfor virker den så klog?

Det skyldes en teknologi, der kaldes en Transformer (især en mekanisme kaldet opmærksomhed eller attention). Den gør, at modellen ikke bare kigger på det allersidste ord, den har skrevet, men kan overskue og huske hele sammenhængen i din tekst. Den ved præcis, hvilke dele af dit spørgsmål, der er vigtigst for at give det rigtige svar.

Vigtigt at huske: Den tænker ikke

En LLM har ingen bevidsthed, ingen sandhedssans og ingen adgang til virkeligheden. Den ved ikke, hvad en "solnedgang" rent faktisk er – den ved bare, hvilke ord der statistisk set passer bedst sammen med ordet "solnedgang". Det er derfor, den nogle gange kan "hallucinere" (opdigte fakta, der lyder fuldstændig troværdige).

Transformer-arkitekturen i dybden

For at forstå, hvordan en LLM (som GPT-4 eller Claude) er bygget op indeni, skal vi kigge på den såkaldte Transformer-arkitektur.
En sprogmodel består af en lang række "byggeklodser" (lag og blokke), som teksten skal igennem. Her er en oversigt over de vigtigste blokke i den rækkefølge, som din tekst møder dem:

Blokkens navn Hvad er dens primære funktion? Simpel analogi
1. TokenizerHakker teksten op i mindre stykker (ord/stavelser) og giver dem et tal-ID.Ordbogen med stregkoder.
2. Embedding LayerOmdanner tallene til rækker af koordinater (vektorer), så computeren forstår ordets betydning.Det semantiske landkort.
3. Positional EncodingTilføjer et tids- eller placeringsstempel, så modellen kender ordrenes rækkefølge.Sidetal på løse ark.
4. Self-AttentionAnalyserer, hvordan alle ordene i en sætning hænger sammen og påvirker hinanden.Detektiven, der finder sammenhænge.
5. Feed-Forward NetworkBehandler den indsamlede viden og opdaterer modellens "forståelse".Tænkeboksen / Fabrikken.
6. Output Layer (Softmax)Omdanner de interne tal tilbage til sandsynligheder for rigtige ord.Målstregen, der vælger det næste ord.

Hvordan virker blokkene i detaljer? (Del 1)

1. Tokenizeren & Embedding-laget (Indgangen)

Når du skriver en sætning, starter den her. Tokenizeren skærer sætningen i stykker. Sætningen "Katten fanger musen" bliver måske til fire bidder: [Kat] [ten] [ fanger] [ musen].
Herefter tager Embedding-laget over. Det slår hvert stykke ord op i et gigantisk koordinatsystem. Hvis ordet "Kat" og "Hund" minder om hinanden, får de koordinater tæt på hinanden. Det er her, modellen opdager, hvad ord betyder i forhold til andre ord.

2. Positional Encoding (Rækkefølgen)

En af de største styrker ved moderne LLM-modeller er, at de læser hele din tekst på én gang i stedet for at læse ét ord ad gangen fra venstre mod højre. Men hvis man læser alt på én gang, mister man rækkefølgen. Positional Encoding klistrer et lille matematisk stempel på hvert ord, der fortæller, om det står som nummer 1, 2 eller 3 i sætningen. Uden dette stempel ville modellen ikke kunne kende forskel på "Hunden spiste maden" og "Maden spiste hunden".

Hvordan virker blokkene i detaljer? (Del 2)

3. Self-Attention-blokken (Hjertet i modellen)

Dette er den vigtigste blok i hele Transformer-arkitekturen. Self-Attention (eller selv-opmærksomhed) gør modellen i stand til at kigge på et ord og regne ud, hvilke andre ord i sætningen, der er vigtige for at forstå det.
Eksempel: Hvis der står: "Banken var lukket, fordi den var gået konkurs", så regner Attention-blokken lynhurtigt ud, at ordet "den" refererer til "Banken" og ikke "lukket". Den tegner så at sige usynlige streger med forskellig vægtning mellem alle ordene i teksten for at forstå konteksten.

4. Feed-Forward-netværket (Tænkeboksen)

Når Attention-blokken har fundet ud af, hvordan ordene hænger sammen, sendes informationen videre til Feed-Forward-netværket. Dette er et tæt netværk af kunstige neuroner.
Hvor Attention-blokken kigger på forholdet mellem ordene, bruger Feed-Forward-blokken modellens lagrede viden (dens "intelligens") til at bearbejde informationen. Det er her, modellen reelt "overvejer", hvad al denne information betyder.
Bemærk: I en rigtig LLM er Self-Attention og Feed-Forward stablet ovenpå hinanden i mange lag (ofte mellem 30 og 100 lag). Dataen suser op igennem disse lag, og for hvert lag bliver modellens forståelse af din tekst dybere og mere nuanceret.

5. Output-laget / Softmax (Udgangen)

Når teksten har været igennem alle lagene, ender den i Output-laget. Her bliver de komplekse interne tal lavet om til en liste over alle ord i dens ordbog, hver med en procentsats for, hvor sandsynligt det er, at netop det ord er det næste i rækken. En funktion kaldet Softmax sørger for, at procenterne tilsammen giver 100%. Modellen vælger herefter typisk det ord med den højeste procentsats, og processen starter forfra for at finde det næste ord.

Self-Attention matematisk forklaret

For at forstå Self-Attention matematisk uden at drukne i hardcore universitets-matematik, skal vi bruge en genial analogi: Et digitalt arkivsystem med forespørgsler, nøgler og værdier.
Matematisk set omdanner modellen hvert eneste ord (token) til tre forskellige vektorer (lister af tal). De kaldes Queries (Q), Keys (K) og Values (V).
Her er de tre roller:

  • Query (Spørgsmålet Q): Hvad leder dette ord efter i resten af sætningen?
  • Key (Nøglen K): Hvad kan dette ord tilbyde? Hvad er min identitet?
  • Value (Værdien V): Hvad er det faktiske indhold eller den betydning, ordet bringer med sig, hvis det er vigtigt?

De 3 matematiske trin i Self-Attention

Når modellen skal finde ud af, hvor meget opmærksomhed to ord skal give hinanden, udfører den følgende tre matematiske operationer:

1. Prikproduktet (Hvor godt matcher vi?)

For at finde ud af, hvor relevant ord A er for ord B, ganger modellen Query-vektoren for det ene ord med Key-vektoren for alle de andre ord. Inden for matematikken kaldes dette et prikprodukt (dot product).
Match = Q × KT
• Hvis Query og Key peger i samme retning i det matematiske rum, bliver tallet højt (perfekt match).
• Hvis de ikke har noget med hinanden at gøre, bliver tallet tæt på nul eller negativt.

2. Skalering og Softmax (Lav det om til procenter)

Hvis tallene fra prikproduktet bliver alt for store, bliver matematikken ustabil. Derfor gør modellen to ting:
1. Skalering: Den dividerer resultatet med kvadratroden af størrelsen på vektorerne (√dk) for at holde tallene nede.
2. Softmax: Den kører tallene igennem en Softmax-funktion. Dette omdanner de rå tal til sandsynligheder (procenter) mellem 0 og 1 (eller 0% og 100%), som tilsammen giver 1.
Nu har modellen en Attention-matrix – en tabel over, nøjagtigt hvor mange procent opmærksomhed hvert ord skal give alle andre ord.

3. Vægtning af værdien (Resultatet)

Til sidst tager modellen procenten og ganger den med Value-vektoren (V).
Attention(Q,K,V) = softmax((Q × KT) / √dk)V
Hvis ordet "Banken" har et 92% match med ordet "den", så bliver 92% af "Bankens" betydning (dens Value) sendt med videre i netværket for at definere ordet "den".

Et konkret eksempel: "Banken lukkede, fordi den..."

Lad os se på, hvad der sker i matematikken, når modellen rammer ordet "den":

Trin Hvad gør matematikken? Resultat i praksis
1. QueryOrdet "den" sender en Query ud: "Jeg er et stedord. Hvem refererer jeg til?"En liste med tal (\(Q\)).
2. Key MatchModellen sammenligner denne Query med alle ords Keys. Ordet "lukkede" har en Key, der siger "Jeg er en handling". Dårligt match. Ordet "Banken" har en Key, der siger "Jeg er et navneord i bestemt form". Perfekt match!Prikproduktet giver et højt tal for "Banken".
3. SoftmaxTallene laves om til procenter."Banken" får 85%, "lukkede" får 5%, "fordi" får 10%.
4. OutputModellen ganger de 85% med Value-vektoren for "Banken".Betydningen af "Banken" smelter matematisk sammen med ordet "den".

Takket være denne matrix af prikprodukter ved modellen nu med matematisk præcision, at når den skal gætte det næste ord, så er det banken, der er kernen i sætningen, og ikke selve det at lukke.

Hierarkisk informationsbehandling

Når man stabler mange lag af Transformer-blokke ovenpå hinanden (ofte mellem 30 og 100 lag i moderne LLM-modeller), sker der noget magisk: Modellen går fra blot at genkende simple ord til at forstå komplekse koncepter, nuancer, logik og abstrakte ideer.
Hvert lag tager outputtet fra det forrige lag, forfiner det og sender det videre opad. Det kaldes en hierarkisk informationsbehandling.

Her er en oversigt over, hvad der sker med teksten, efterhånden som den bevæger sig op igennem lagene:

Niveau i lagene Hvad fokuserer modellen på her? Hvad "forstår" modellen i dette lag?
De laveste lag (Lag 1–10)Overfladisk struktur og grammatik.Den ser, hvilke ord der er navneord, udsagnsord, og hvordan ordene umiddelbart hænger sammen i korte sætninger.
De midterste lag (Lag 11–40)Kontekst, temaer og henvisninger.Den løser stedord (som i eksemplet med "den" og "banken") og forstår det overordnede emne (f.eks. "økonomi", "madlavning" eller "jura").
De højeste lag (Lag 41–80+)Abstrakt tænkning, logik og hensigt.Den gennemskuer sarkasme, fanger den røde tråd, forstår koder/programmering og regner ud, hvorfor du stiller spørgsmålet.

Processen: Fra rådata til dyb forståelse

For at forstå hvorfor stablingen er så vigtig, kan man se på, hvordan informationen forandrer sig undervejs:

1. Akkumulering af information (Sneboldeffekten)

I det allerførste lag kigger Self-Attention-mekanismen kun på ord, der står tæt på hinanden. Men i lag 2 kigger modellen på resultatet af lag 1. Det betyder, at lag 2 indirekte kigger på et større område af teksten. Når du når op til lag 60, har hvert enkelt "ord" (token) opsuget information fra hele dit prompt. Ordet er ikke længere bare et ord – det er blevet til en matematisk pakke fyldt med kontekst.

2. "Genveje" sikrer, at modellen ikke glemmer (Residual Connections)

Når man stabler 80 lag ovenpå hinanden, opstår der et matematisk problem: Information kan blive udvandet eller forvrænget på vejen op (hvilket i matematikken kaldes vanishing gradients).
For at løse dette bruger man residual connections (restforbindelser). Det er digitale motorveje, der tillader den oprindelige tekst at springe over visse matematiske beregninger og flyde direkte med op til de højere lag. På den måde mister modellen aldrig grebet om, hvad du oprindeligt spurgte om.

3. Emergerende egenskaber (Når kvantitet bliver til kvalitet)

Det fascinerende ved at stable rigtig mange lag (og gøre modellen stor) er, at der opstår såkaldte emergerende egenskaber. Det er evner, som udviklerne ikke direkte har kodet modellen til at have, men som pludselig opstår, når netværket bliver dybt nok. Det er i de øverste lag, at modellen pludselig bliver i stand til at:

  • Følge komplekse, logiske ræsonnementer (f.eks. løse matematiske gåder).
  • Forstå og skrive avanceret computerkode.
  • Skifte toneleje, så den f.eks. svarer som en pirat eller en professionel advokat.

En simpel analogi: Efterretningstjenesten

Forestil dig en LLM som en stor efterretningstjeneste:

  • De laveste lag er agenterne i marken. De læser dokumenterne og streger vigtige ord under.
  • De midterste lag er analytikerne. De samler rapporterne fra agenterne og skriver resuméer om de enkelte emner.
  • De øverste lag er cheferne og generalerne. De kigger på det store billede, forbinder de forskellige resuméer og træffer den endelige beslutning om, hvad det næste strategiske træk (det næste ord) skal være.

Træningen og Temperature

Træningen skaber modellens hjerne, mens Temperature styrer, hvor vovemodig hjernen skal være, når den svarer dig.

Del 1: Hvordan træner man en gigantisk bunke lag?

At træne en LLM minder om en blanding af rå intensiv statistik og pædagogisk opdragelse. Det foregår altid i to store faser:

Fase 1: Pre-training (Den rå tekst-støvsuger)

Dette er den dyreste og mest computer-tunge fase. Her slipper man modellen løs på milliarder af tekster fra internettet, bøger og artikler.
• Metoden (Masked Language Modeling): Man viser modellen en sætning, hvor det sidste ord er slettet – f.eks. "Græsset er [MANGLEVDE ORD]".
• Gæt og fejl: I starten gætter modellen helt tilfældigt (f.eks. "bil" eller "blå"). Hver gang den gætter forkert, brokker systemet sig matematisk (via en loss function), og modellens milliarder af tal (vægte) i de mange lag justeres en lille smule via en algoritme, der kaldes Backpropagation.
• Resultatet: Efter at have gentaget dette milliarder af gange, er modellen blevet en mester i statistik. Den har udviklet sin enorme sprogforståelse, men den er stadig bare en avanceret søgemaskine/ordgætter. Hvis du skriver: "Kan du hjælpe mig med at skrive et digt?", gætter den måske bare, at det næste logiske på internettet ville være: "Ja, det kan jeg godt, sagde Søren." i stedet for rent faktisk at skrive digtet.

Fase 2: Fine-tuning & Alignment (Opdragelsen)

For at gøre modellen til en høflig og hjælpsom assistent, skal den opdrages. Det gøres i dag primært med to teknikker:
1. Instruction Tuning: Man fodrer modellen med tusindvis af eksempler på perfekte spørgsmål og svar (f.eks. Spørgsmål: "Skriv et digt om efterår", Svar: "Bladene falder...").
2. RLHF (Reinforcement Learning from Human Feedback): Mennesker (og andre AI-modeller) læser modellens svar og giver dem karakterer. Hvis modellen svarer racistisk, farligt eller vrøvler, får den "straf". Svarer den præcist og venligt, får den en "belønning". Dette låser modellens evner fast, så den opfører sig som den chatbot, du kender.

Temperature: Styr kreativiteten

Del 2: Hvordan styrer man kreativiteten med Temperature?

Når modellen er færdigtrænet, står den ved hvert eneste ord og beregner en sandsynlighed for alle ord i dens ordbog. Lad os sige, at modellen har skrevet: "Der var engang en..."
Output-laget (Softmax) spytter disse rå procenter ud:
• konge: 65%
• trold: 20%
• lille: 10%
• rumraket: 0,1%

Det er her, Temperature (temperaturen) kommer ind i billedet som en matematisk regulator. Det er en skyder, du typisk kan indstille mellem 0.0 og 2.0:

Temperature-indstilling Hvad sker der matematisk? Hvordan opleves svaret? Bedst til...
Lav (f.eks. 0.2)De høje procenter bliver endnu højere, og de lave procenter barberes helt væk. "Konge" bliver sat op til 99%.Modellen vælger altid det mest sikre og forudsigelige ord. Svaret bliver meget præcist, robotagtigt og ensformigt. Stiller du det samme spørgsmål ti gange, får du det samme svar.Programmering, matematik, faktatjek og dataanalyse.
Standard (f.eks. 0.7)Procenterne forbliver nogenlunde, som modellen har lært dem. "Konge" vælges oftest, men "trold" og "lille" har en reel chance.Svaret lyder naturligt, flydende og menneskeligt. Der er en god balance mellem forudsigelighed og variation.Almindelig samtale, e-mails og resuméer.
Høj (f.eks. 1.5)Forskellene mellem procenterne udviskes (flades ud). "Konge" falder måske til 30%, mens "rumraket" pludselig hopper op på 15%.Modellen bliver "beruset" og ekstremt vovemodig. Den begynder at vælge mærkelige, uforudsigelige ord. Svarene bliver meget kreative, men risikoen for, at den sludrer eller hallucinerer, eksploderer.Brainstorming, digtning og kreative historier.

Kort sagt: Træningen giver modellen adgang til hele paletten af ord, mens Temperature bestemmer, om den skal spille det sikre kort eller tage en chance med de mere sjældne og skøre ord på paletten.

Hallucinationer

Når en LLM hallucinerer – altså finder på ting, der er faktuelt forkerte, men lyder fuldstændig sande – føles det som om, den lyver for dig med vilje. Men sandheden er, at en LLM slet ikke kan lyve. For at lyve skal man kende sandheden og bevidst vælge at sige noget andet.
En LLM kender ikke sandheden. Den kender kun sandsynlighed.
Her er de vigtigste årsager til, at hallucinationer opstår, og hvorfor de er så svære at gennemskue:

1. Den er designet til at behage, ikke til at tjekke fakta

En LLM er programmeret til at fuldføre tekst, så det lyder som et naturligt, menneskeligt svar. Under træningen (RLHF) lærer den, at mennesker godt kan lide fyldestgørende, selvsikre og flydende svar. Den lærer derimod ikke, hvornår den skal stoppe op og sige: "Det ved jeg faktisk ikke, lad mig lige slå det op i en sikker database". Hvis du spørger den om noget obskurt, gætter den ud fra de statistiske mønstre, den kender, og præsenterer gættet med præcis samme autoritet som alt andet.

2. Statistisk "blendning" (Når mønstre smelter sammen)

Husk på, at en LLM gemmer information som talværdier (vægte) i et gigantisk netværk, ikke som specifikke filer eller dokumenter. Hvis to koncepter ligger tæt på hinanden i modellens "hjerne", kan den nemt komme til at blande dem sammen.
• Eksempel: Hvis du spørger om en mindre kendt dansk historisk person, tager modellen personens navn, men låner måske fødselsåret fra en anden person fra samme tidsperiode, fordi de to personer deler mange af de samme matematiske træk i modellens lag. Resultatet bliver en helt ny, fiktiv tidslinje, der lyder plausibel, fordi konteksten (1800-tallets Danmark) passer perfekt.

3. "Kreativitet" og Temperature kammer over

Som vi så med Temperature, vælger modellen ikke altid det 100% mest sandsynlige ord, da sproget ellers ville blive for kedeligt og mekanisk. Men når den vælger et ord, der kun er 5% sandsynligt, ændrer det hele retningen for resten af sætningen. Det næste ord skal nu passe til det "mærkelige" ord, og før man ser sig om, har modellen sporet sig selv ind på en tangent, der er ren fiktion.

Hvorfor lyder hallucinationer så overbevisende?

Det er her, den virkelige fælde klapper for os mennesker. Modellen lyver så overbevisende på grund af to ting:
A. Grammatisk perfektion
Vores menneskelige hjerne er kodet til at forbinde godt sprog med høj intelligens og troværdighed. Fordi en LLM er en sprogmodel, fejler dens grammatik, tegnsætning og toneleje næsten aldrig. Når en løgn bliver serveret i et fejlfrit, akademisk og professionelt sprog, stoler vi automatisk mere på den, end hvis den var fuld af stavefejl.
B. Sandhed og fiktion blandes (80/20-reglen)
En hallucination er sjældent 100% vrøvl. Den består ofte af 80% sandhed og 20% fiktion.
Hvis du beder den om en biografi af en kendt professor, vil den ramme rigtigt på universitetet, faget og mange af bøgerne – men den kan finde på at opdigte titlen på to artikler, som professoren kunne have skrevet, og give dem fiktive udgivelsesår. Fordi alt det udenom er rigtigt, opdager man kun fejlen, hvis man eftertjekker hver eneste detalje.

Hvordan løser man det i dag?

For at mindske hallucinationer bruger man i dag en teknik, der hedder RAG (Retrieval-Augmented Generation). Her tvinger man modellen til at foretage en søgning (f.eks. på Google eller i et specifikt dokument) før den svarer. Den bruger så søgeresultatet som sit "fakta-anker", hvilket forhindrer den i blot at gætte ud fra sine interne procenter.
Store modeller (LLM) vs. Små modeller (SLM)

Forskellen på en stor sprogmodel (LLM) som f.eks. GPT-4 og en lille sprogmodel (SLM – Small Language Model), der kan køre lokalt på din smartphone (som f.eks. Googles Gemini Nano eller Microsofts Phi-3), kan bedst sammenlignes med forskellen på et stort universitetsbibliotek og en rigtig god lommeordbog.
Her er de primære forskelle opdelt på de mest kritiske parametre:

Parameter Stor model (f.eks. GPT-4) Lille model (f.eks. til telefon)
Hvor kører den?På gigantiske sky-servere (datacentre) ejet af tech-giganter.Lokalt på chippen i din smartphone eller computer.
Antal parametre ("hjerneceller")Estimeret til hundredvis af milliarder eller billioner.Typisk mellem 1 og 7 milliarder.
InternetkravObligatorisk. Uden internetforbindelse kan du ikke bruge den.Intet krav. Fungerer 100% offline (f.eks. i flytilstand).
Hukommelse & LogikKan løse ekstremt komplekse, logiske opgaver og huske enorme tekster.God til kortere, specifikke opgaver. Mister hurtigere den røde tråd.
PrivatlivDine data sendes over internettet til eksterne servere.100% privat. Dine data forlader aldrig din telefon.
Strøm & ØkonomiKoster millioner af kroner i strøm at holde kørende hver dag for udbyderen.Bruger minimalt batteri på din telefon.

Hvordan kan en lille model overhovedet være på en telefon?

For at presse en sprogmodel ned på en smartphone, bruger udviklerne to geniale metoder:
1. Kvantisering (Det matematiske kompromis)
I en stor model gemmes alle talværdierne (vægtene) med ekstremt høj præcision (f.eks. 16-bit eller 32-bit decimaltal). Det fylder enormt meget plads.
Ved kvantisering runder man tallene af til f.eks. 4-bit eller 8-bit heltal. Det svarer til at ændre et billede fra ultraskarp 4K-opløsning til en god HD-kvalitet. Modellen mister en lille smule nuancerigdom, men til gengæld skrumper filstørrelsen fra 500 gigabyte til blot 2–4 gigabyte, hvilket nemt kan være på en telefon.
2. Vidensdestillation (Lærling-metoden)
Man tager en gigantisk model (mesteren) og lader den træne den lille model (lærlingen). Den store model sorterer alt det overflødige vrøvl fra internettet fra og lærer kun den lille model de absolut vigtigste mønstre og logikker. Den lille model bliver derfor langt mere effektiv i forhold til sin størrelse.

Hvad bruger man dem til i praksis?

De to modeltyper udelukker ikke hinanden, men er gode til hver deres ting:
• Den store model (Skyen): Den bruger du, når du skal have skrevet et avanceret stykke computerkode, analyseret et 80-siders PDF-dokument, eller hvis du har brug for en dybdegående filosofisk sparringspartner.
• Den lille model (Telefonen): Den kører i baggrunden på din telefon. Den hjælper med at foreslå smarte svar på dine SMS'er, rette dine stavefejl, sortere dine billeder, oversætte menuer live, når du rejser uden mobildata, eller opsummere en telefonsamtale – alt sammen lynhurtigt og uden at dræne dit batteri.

Computerens hardware (Del 1)

Her er de præcise tekniske forklaringer på, hvordan computerens hardware påvirker afviklingen af lokale AI-modeller, og hvorfor arkitekturen har ændret sig radikalt.

1. Hvorfor kræver det så meget RAM at køre en LLM?

Når du kører en sprogmodel lokalt, skal hele modellens "hjerne" ligge klar i arbejdshukommelsen (RAM/VRAM) på én gang.
Modeller består af milliarder af tal (parametre/vægte). En ukomprimeret model lagrer typisk hvert tal i et format, der fylder 2 bytes (FP16). En mellemstor model med 70 milliarder parametre kræver derfor svimlende 140 GB RAM alene for at indlæse filen. Selvom man bruger kvantisering (hvor tallene rundes af, så de f.eks. kun fylder 4 bits/0,5 byte per parameter), skal en 70B-model stadig bruge omkring 35-42 GB ren hukommelse – dertil skal lægges ekstra RAM til at huske din igangværende samtale (den såkaldte KV Cache). Hvis modellen ikke kan være i RAM'en, kan den slet ikke køre.

2. Hvorfor skal det være hurtig VRAM?

Generering af tekst fra en LLM fungerer ved, at modellen gætter ét ord (token) ad gangen. For at spytte bare ét enkelt ord ud, skal processoren læse samtlige milliarder af parametre igennem én gang.
Hvis du vil have en hastighed på 30 ord i sekundet på en model, der fylder 40 GB, skal computeren flytte 30 × 40 GB = 1200 GB data i sekundet. Almindelig system-RAM til computere er alt for langsom til denne massive datastrøm. VRAM (Video RAM), som sidder direkte på grafikkortet, er specialbygget til ekstremt høj båndbredde (ofte mellem 500 og 1.700 GB/s på moderne grafikkort). Jo hurtigere båndbredde din VRAM har, desto flere ord kan modellen spytte ud i sekundet.

3. Hvorfor er et grafikkort (GPU) hurtigere end en CPU?

Arkitekturen i de to processorer er vidt forskellig:
• En CPU er som en flok Nobelpris-forskere (f.eks. 8 til 24 kerner). De er ekstremt hurtige til at løse svære, komplekse opgaver én efter én (seriel databehandling).
• En GPU er som en hær af 10.000 skolebørn, der alle kan løse simple plusstykker på samme tid (parallel databehandling).
AI-modeller består dybest set af gigantiske tabeller med tal, der skal ganges og lægges sammen (matrix-matematik). Det er milliarder af ultra-simple regnestykker, der kan løses uafhængigt af hinanden. Her raser en GPU fuldstændig fra en CPU, fordi den kan udføre tusindvis af disse beregninger samtidigt, hvilket gør den 10 til 50 gange hurtigere til AI end en traditionel CPU.

Computerens hardware (Del 2)

4. Hvordan shared/unified RAM (fastloddet) er bedre til AI

På en traditionel Windows-PC er RAM og VRAM adskilt. Grafikkortet har f.eks. 16 GB hurtig VRAM, og bundkortet har 32 GB almindelig RAM. Hvis en AI-model fylder 24 GB, kan den ikke være på grafikkortet. Den må "splittes" op, så resten ligger i computerens almindelige RAM. Hver gang GPU'en skal bruge data fra den almindelige RAM, opstår der en enorm flaskehals, fordi data skal sendes over et langsomt PCIe-stik, hvilket får hastigheden til at falde dramatisk.
Shared/Unified Memory (især når det er fastloddet helt tæt på processoren) fjerner denne flaskehals fuldstændigt:
• Der er kun én stor pulje af hukommelse.
• Både CPU'en, GPU'en og AI-kredsløbet kigger ind i den samme pulje.
• Data skal aldrig kopieres eller flyttes mellem to forskellige RAM-klodser. Hvis GPU'en skal bruge noget, som CPU'en lige har hentet, kigger den bare på den samme adresse i hukommelsen. At det er fastloddet gør desuden de fysiske baner kortere, hvilket tillader langt højere hastigheder og lavere responstid.

5. Hvorfor Apples M-chips er suveræne til lokal AI

NVIDIA laver de absolut hurtigste grafikkort (f.eks. RTX 4090/5090), men de er låst til maksimalt 24 eller 32 GB VRAM i konsument-klassen. Hvis du vil køre de helt store, intelligente AI-modeller (f.eks. 70B+ parametre), kan de simpelthen ikke være på et almindeligt grafikkort.
Apple Silicon (M-serien) brillerer, fordi deres Unified Memory Architecture (UMA) tillader, at du kan købe en maskine (f.eks. en Mac Studio eller MacBook Pro) med 128 GB, 192 GB eller helt op til 512 GB RAM. Fordi puljen er delt, forvandles hele denne enorme RAM-pulje reelt til "VRAM" for grafik- og AI-kernen. Samtidig har top-modellerne (som Max- og Ultra-chippene) en massiv hukommelsesbåndbredde (op til 800 GB/s), hvilket gør dem i stand til at afvikle gigantiske modeller lokalt, som ingen bærbar Windows-PC overhovedet kan indlæse.

6. Fremtiden: Hvordan NPU'er vil overtage AI-kørslen lokalt

Selvom GPU'en er hurtig, har den et stort problem: Den er en strømsuger uden lige. Hvis du kører en AI-model lokalt på en bærbar computer via GPU'en, dør batteriet på kort tid, og blæserne vil larme i vildskab.
Her kommer NPU'en (Neural Processing Unit) ind i billedet. Hvor en GPU er bygget til både at lave computerspil, 3D-grafik og AI, er en NPU en co-processor, der udelukkende er designet til AI-matematik.
• Ekstrem strømeffektivitet: NPU'en klipper alle overflødige funktioner væk og fokuserer 100% på de kredsløb, der skal bruges til LLM-modeller. Det gør, at den kan køre AI-opgaver med en brøkdel af det strømforbrug, en GPU kræver.
• Arbejdsfordeling: I fremtiden vil din GPU og CPU holde helt fri, når du taler med din lokale AI. NPU'en vil ligge i baggrunden og tygge sig igennem dine prompts, kigge på dine data og køre mindre, højeffektive sprogmodeller lokalt – uden at din computer bliver varm, og uden at dit batteri drænes.

RAM, Båndbredde og Valg af Model

1. Hvilke konkrete modeller passer til forskellige RAM-størrelser?

For at en model kan køre fornuftigt, skal filstørrelsen (ofte i det populære GGUF-format til lokal kørsel) samt samtalehukommelsen (KV Cache) kunne være i din RAM/VRAM. De fleste brugere anvender modeller, der er kvantiseret til 4-bit (Q4), hvilket balancerer intelligens og filstørrelse perfekt.
Her er et overblik over, hvilke open-source topmodeller der passer til din computers RAM:

RAM-kapacitet Modelstørrelse (Parametre) Konkrete model-anbefalinger Hvad kan de bruges til?
8 GB - 16 GB1B til 4B / 8B (hård grænse)Llama 3.2 (1B/3B), Qwen 2.5 (3B/7B), Phi-3.5-mini (3.8B)Perfekt til hverdagsopgaver, hurtige e-mails, simple kodeskrivninger og hurtig chat på helt almindelige laptops.
32 GB7B til 14BLlama 3.1 (8B), Mistral (7B), Gemma 2 (9B/27B Q2), Qwen 2.5 (14B)Det "gyldne punkt" for lokal AI. Meget høj intelligens, god til dyb logik, avanceret programmering og komplekse resuméer.
64 GB32B til 70B (stramt)Qwen 2.5 (32B), Llama 3.1 (70B Q2/Q3), Command R (35B)Semiprofessionelt niveau. Modellerne har dyb sprogforståelse og fanger nuancer næsten på niveau med kommercielle cloud-AI'er.
128 GB+70B+ til 405BLlama 3.1 (70B Q4/Q8), Mistral Large, Llama 3.1 (405B - kræver massiv hardware)Professionelt arbejde og virksomhedsbrug. Kan erstatte betalte skytjenester fuldstændigt med ekstremt præcise svar.

Tip: Du kan bruge onlinetjenester eller værktøjet llmfit til automatisk at aflæse din hardware og se præcis, hvilke modeller der passer.

2. Hvordan tjekker man sin computers hukommelses-båndbredde?

Da din AI-hastighed (tokens per sekund) er direkte begrænset af, hvor hurtigt data kan flyttes fra dine RAM til din processor, er båndbredden afgørende. Du kan beregne eller måle den på følgende måder:

Den teoretiske metode (Matematisk)
Du kan nemt finde dit systems teoretiske maks-hastighed ved at kigge på din RAM-type. Hvis du har en Windows-PC, kan du åbne Jobliste (Ctrl+Shift+Esc) -> Ydeevne -> Hukommelse for at se din RAM-hastighed (f.eks. 4800 MHz, 5600 MHz eller 6400 MHz).
• Almindelig PC (DDR5 i Dual Channel): Kører typisk med en båndbredde på 60 – 100 GB/s.
• Dedikeret VRAM (f.eks. RTX 4090): Har sit eget lynhurtige kredsløb, der flytter over 1.000 GB/s.
• Apple Silicon (Unified): En standard M-chip leverer omkring 100 GB/s, mens Pro-chippen yder 200 GB/s, Max-chippen 400 GB/s, og Ultra-chippen runder 800 GB/s.

Den praktiske metode (Benchmark)
For at måle den faktiske reelle hastighed lige nu, kan du downloade gratis open-source testværktøjer:
• Windows/Linux: Download det klassiske værktøj Intel MLC (Memory Latency Checker) eller kør en hukommelsestest i AIDA64.
• Mac: Åbn din Terminal og kør værktøjet osxbewench eller brug Command Line-værktøjet memory_bandwidth.

3. Hvordan bruger man Intels onboard-grafikkort (iGPU) til LLM?

Mange mini-computere (især med i9 mobil-processorer) kommer med stærke indbyggede grafikkort som Intel Iris Xe eller nyere Intel Arc Graphics. Selvom de deler computerens almindelige RAM, kan de bruges til at accelerere dine LLM-modeller markant frem for kun at bruge CPU'en.
For at tvinge AI'en over på Intels onboard-grafik, skal du gå uden om NVIDIAS standard-software (CUDA) og i stedet bruge Intels egen platform, som hedder oneAPI / OpenVINO.
Her er de to letteste måder at gøre det på i praksis:

Metode A: Gennem Ollama (Den letteste vej)
Sprogmodel-motoren Ollama har indbygget understøttelse af Intel GPU'er via spidsteknologier som SYCL/oneAPI.
1. Sørg for, at du har installeret de absolut nyeste Intel Graphics Drivers til din i9-processor.
2. Installer InteloneAPI Base Toolkit på din computer.
3. Når du starter Ollama, vil programmet automatisk genkende din Intel Iris Xe/Arc iGPU og offloade beregningerne til den, hvilket fjerner byrden fra din CPU.

Metode B: Gennem "LLM on Intel" (Llama.cpp med OpenVINO)
Hvis du vil have maksimal ydeevne ud af din i9 mini-PC, skal du bruge OpenVINO-backend-versionen af Llama.cpp.
1. Installer Python og biblioteket openvino.
2. Du kan køre modeller direkte via terminalen ved at tilføje kommandoen -ngl (number of GPU layers) og vælge enheden GPU i stedet for CPU. Det fortæller programmet, at grafikchippen i din i9-processor skal tygge sig igennem modellens matematiske lag.

Kom i gang med lokal AI

Nu forstår du mekanikken bag modellerne. Uanset din hardware kan du hente og køre åbne LLM'er lokalt for at sikre privatliv, uafhængighed og innovation.